GEO
robots.txt a boty AI: które wpuścić, a które zablokować.
Które boty AI trenują modele, a które odpowiadają za widoczność w ChatGPT, Claude i Perplexity. Gotowe reguły robots.txt do skopiowania i najczęstsze błędy.
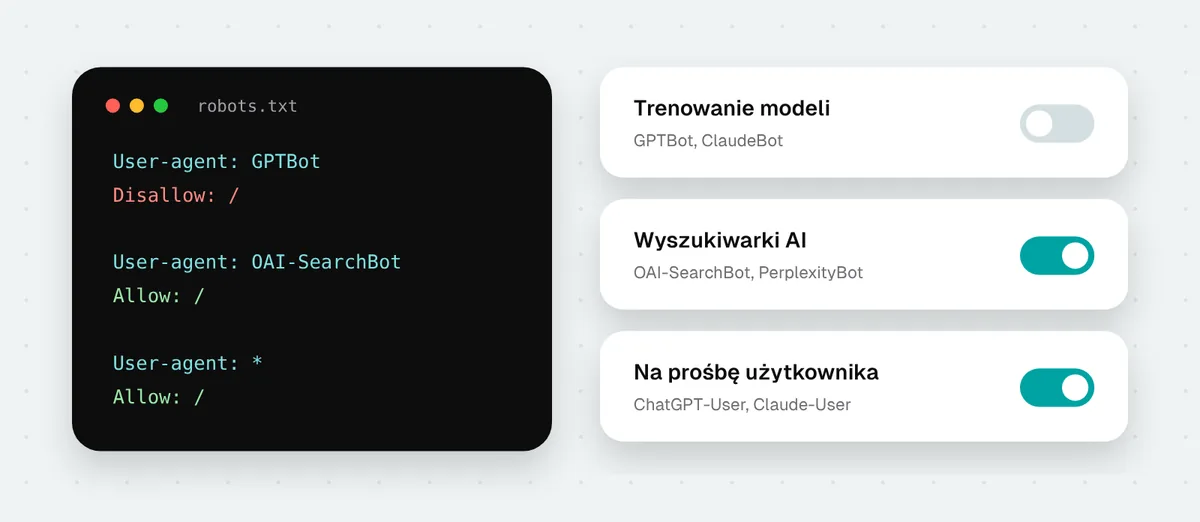
Coraz więcej firm dopisuje do robots.txt blokadę „dla AI”, bo nie chce, żeby ich treści trenowały modele. Często blokuje przy okazji coś, czego wcale nie chciała: widoczność w wyszukiwarce ChatGPT, Claude czy Perplexity. Dzieje się tak, bo pod hasłem „boty AI” kryją się trzy różne rodzaje botów i każdy blokuje się osobno. Poniżej wyjaśniam, który bot do czego służy, i daję gotowe reguły do skopiowania.
Trzy rodzaje botów AI
- Boty trenujące modele. Zbierają treści, z których powstają kolejne wersje modeli. Blokada sprawia, że Twoje przyszłe treści nie trafią do treningu. Nie usuwa strony z wyszukiwarek AI.
- Boty wyszukiwarek AI. Budują indeks, z którego ChatGPT, Claude czy Perplexity biorą strony do odpowiedzi z wyszukiwania. Blokada oznacza, że strona przestaje się tam pojawiać.
- Boty działające na prośbę użytkownika. Otwierają stronę wtedy, gdy ktoś poprosi czat o sprawdzenie konkretnego adresu albo gdy narzędzie szuka odpowiedzi na żywo. OpenAI i Perplexity piszą wprost, że takie boty mogą pomijać robots.txt, bo pobranie zlecił człowiek.
| Bot | Firma | Do czego służy | Co daje blokada |
|---|---|---|---|
| GPTBot | OpenAI | Trenowanie modeli | Treści nie trafią do treningu. Wyszukiwarka ChatGPT działa dalej. |
| OAI-SearchBot | OpenAI | Wyszukiwarka ChatGPT | Strona znika z odpowiedzi wyszukiwarki ChatGPT, zostaje najwyżej jako link nawigacyjny. |
| ChatGPT-User | OpenAI | Pobieranie strony na prośbę użytkownika | Reguły robots.txt mogą nie być stosowane. |
| ClaudeBot | Anthropic | Trenowanie modeli | Przyszłe treści nie trafią do treningu. |
| Claude-SearchBot | Anthropic | Wyszukiwanie w Claude | Mniejsza widoczność w wynikach wyszukiwania Claude. |
| Claude-User | Anthropic | Pobieranie strony na prośbę użytkownika | Claude nie pobierze strony, gdy ktoś o nią zapyta. |
| PerplexityBot | Perplexity | Wyszukiwarka Perplexity | Strona przestaje pojawiać się w wynikach Perplexity. Perplexity pisze, że nie używa tego bota do trenowania modeli. |
| Perplexity-User | Perplexity | Pobieranie strony na prośbę użytkownika | Zwykle pomija robots.txt. |
| Google-Extended | Zgoda na użycie treści do trenowania Gemini | Nie wpływa na wyniki wyszukiwania Google ani na AI Overviews. | |
| Applebot-Extended | Apple | Zgoda na użycie treści do trenowania modeli Apple | Nie wpływa na wyszukiwanie w Apple. |
| meta-externalagent | Meta | Zbieranie treści do modeli AI Meta | Treści nie trafią do treningu modeli Meta. |
| CCBot | Common Crawl | Publiczne archiwum sieci, z którego korzysta wiele firm AI | Strona nie trafi do kolejnych zbiorów Common Crawl. |
A co z Google?
Z Google jest najwięcej nieporozumień. AI Overviews i AI Mode korzystają z tego samego indeksu co zwykłe wyniki, czyli z Googlebota. Jeśli zablokujesz Googlebota, znikniesz z Google w ogóle, nie tylko z odpowiedzi AI.
Google-Extended to nie jest osobny robot, tylko znacznik w robots.txt, którym mówisz Google, czy treści może używać do trenowania Gemini. Według Google nie wpływa on na to, czy i jak wysoko strona pojawia się w wyszukiwarce. Żeby wyłączyć całą stronę z AI Overviews i AI Mode, Google daje od 2026 roku osobne ustawienie w Search Console. Pojedyncze fragmenty ograniczysz tymi samymi ustawieniami co zwykłe opisy w wynikach: nosnippet, data-nosnippet i max-snippet. Wszystkie te możliwości porównuję w tekście AI w Search Console: nowy raport i przełącznik.
Gotowe reguły do skopiowania
Wariant 1: chcę być widoczny wszędzie
Dla większości firm usługowych to najlepszy wybór. Nic nie blokujesz, a AI może znać Twoją firmę i polecać ją w odpowiedziach.
User-agent: *
Allow: /

Sitemap: https://twojastrona.pl/sitemap.xml
Wariant 2: wyszukiwarki AI tak, trenowanie modeli nie
Strona zostaje widoczna w wyszukiwarkach ChatGPT, Claude i Perplexity, ale prosisz, żeby treści nie trafiały do treningu modeli.
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: meta-externalagent
Disallow: /

User-agent: *
Allow: /

Sitemap: https://twojastrona.pl/sitemap.xml
Wariant 3: blokuję wszystkie boty AI
Świadoma decyzja, na przykład przy płatnych treściach. Strona znika z wyszukiwarek AI, a w Google zostaje, bo Googlebot nie jest zablokowany. Boty działające na prośbę użytkownika są tu wpisane, ale mogą tę regułę pominąć.
User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: ClaudeBot
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: meta-externalagent
Disallow: /

User-agent: *
Allow: /

Sitemap: https://twojastrona.pl/sitemap.xml
Jeśli Twój robots.txt ma już reguły dla wszystkich botów, na przykład blokadę panelu administracyjnego, dopisz je też do grup powyżej. O tym w pierwszym błędzie niżej.
Najczęstsze błędy
- Osobna grupa dla bota kasuje reguły ogólne. Bot, który ma w robots.txt własną grupę, stosuje tylko ją, a reguły z
User-agent: *pomija. Jeśli dopiszeszUser-agent: GPTBotz jedną regułą, GPTBot przestanie respektować na przykład blokadę katalogu/admin/z grupy ogólnej. - Blokada „wszystkiego z AI” z gotowej listy. Listy kopiowane z internetu często mieszają boty trenujące z botami wyszukiwarek. Efekt: firma znika z ChatGPT, choć chciała tylko wyłączyć trening.
- Zapora blokuje to, na co robots.txt pozwala. Cloudflare i część firm hostingowych mają własne ustawienia blokowania botów AI i zmieniały już domyślne zachowanie dla nowych domen. Bot może dostać odmowę dostępu, choć robots.txt go wpuszcza. Zajrzyj do ustawień botów w panelu Cloudflare albo hostingu.
- Zapomniane subdomeny. robots.txt działa tylko dla domeny, na której leży. Sklep na
sklep.twojastrona.plpotrzebuje własnego pliku. - Plik, którego nie ma. Jeśli
/robots.txtzwraca stronę błędu z kodem 200 albo błąd serwera 5xx, boty mogą zinterpretować to różnie. Plik powinien istnieć i zwracać zwykły tekst.
Jak sprawdzić swoją stronę
Najprościej w naszym teście botów AI. Wpisujesz adres, a narzędzie pokazuje, co robots.txt mówi kilkunastu botom i czy serwer nie odrzuca ich po cichu, mimo że plik je wpuszcza.
Pamiętaj też, że większość botów AI nie uruchamia JavaScriptu. Jeśli treść Twojej strony pojawia się dopiero po załadowaniu skryptów, bot może zobaczyć prawie pustą stronę. Sprawdzisz to narzędziem surowy HTML a JavaScript.
Więcej o tym, jak trafić do odpowiedzi AI, piszę w tekście GEO w praktyce: jak trafić do ChatGPT, a o tym, jak mierzyć ruch z AI, w poradniku ruch z ChatGPT i AI w GA4.
Źródła
- Overview of OpenAI Crawlers - OpenAI
- Does Anthropic crawl data from the web, and how can site owners block the crawler? - Anthropic
- Perplexity Crawlers - Perplexity
- AI features and your website - Google Search Central
- Control content use for AI training with Cloudflare's managed robots.txt - Cloudflare
Czy ten artykuł był pomocny?
Super, cieszę się, że się przydał!
Szkoda. Napisz mi, czego zabrakło - poprawię artykuł: info@outrank.pl
O autorze. Maciek - konsultant SEO i GEO z ponad 10-letnim doświadczeniem, wcześniej Head of SEO m.in. w Gemini Polska i Staples Solutions. Więcej o mnie